FinOps · Mécanisme
Écrit une fois, zéro token ? Quand il faut rappeler un modèle
À quels moments un programme écrit par une IA rappelle un modèle, et cinq questions à poser à son fournisseur. Pour qui suit le coût d'une tâche récurrente.
Par Yaniv Benichou Publié le 10 min de lecture
En bref
À l’exécution, un programme écrit par une IA n’appelle aucun modèle, sauf s’il contient lui-même un appel : un script ordinaire n’en contient pas, et les agents-programmes de Nestor sont conçus de même. Mais le programme vit : quand un modèle écrit sa modification, sa réparation après un changement de format ou son adaptation à un autre fichier, c’est un nouvel appel, et une conversation avec un assistant peut en être un autre ; un appel à un modèle d’API se facture aux tokens. Le coût d’une tâche récurrente se lit donc en moments où un modèle est appelé, pas dans un zéro qui vaudrait pour toute sa vie.
Un programme écrit par une IA ne coûte-t-il vraiment plus rien à l’exécution ?
Voici ce que disent deux pages qui comparent un agent à une automatisation classique. Dans une chronique d’avril 2026, le Journal du Net écrit qu’un script simple insère une ligne dans un tableur « sans consommer un seul token », et qu’une automatisation classique réglée en vingt minutes intègre sans coût de tokens, dans un CRM, le fichier Excel que l’équipe commerciale envoie chaque semaine [1]. En septembre 2026, Leyton rappelle que tous les processus n’appellent pas un agent : quand les étapes ne varient pas, une automatisation traditionnelle peut coûter moins cher, aller plus vite et se comporter de façon plus prévisible [2].
La lecture courante : le programme est l’option économique face à l’agent. Ce qu’elle rate : ni l’une ni l’autre de ces pages ne traite l’entretien d’un programme après sa mise en service, c’est-à-dire sa modification, sa réparation et son adaptation. Dans l’exemple du Journal du Net, que se passe-t-il le jour où l’équipe commerciale renomme ou déplace une colonne de son fichier ? Selon la façon dont il est écrit, le programme peut s’arrêter ou lire la mauvaise colonne, et quelqu’un doit alors le modifier.
Notre article précédent montrait ce que reçoit le modèle quand il écrit un programme sur vos fichiers. Celui-ci suit le programme après son écriture : à quels moments rappelle-t-il un modèle ? KastorLab développe Nestor, dont l’une des promesses est 0 token par exécution : nous avons un intérêt dans ce sujet, et nous cherchons ici ce que ce zéro ne couvre pas.
Les moments où un modèle est appelé dans la vie d’une tâche récurrente
Prolongeons l’exemple du Journal du Net : chaque semaine, un fichier Excel à intégrer dans un CRM. Un modèle écrit le programme, une personne le relit, puis le programme s’exécute à chaque échéance. Plus tard, le fichier change, et il faut modifier le programme.
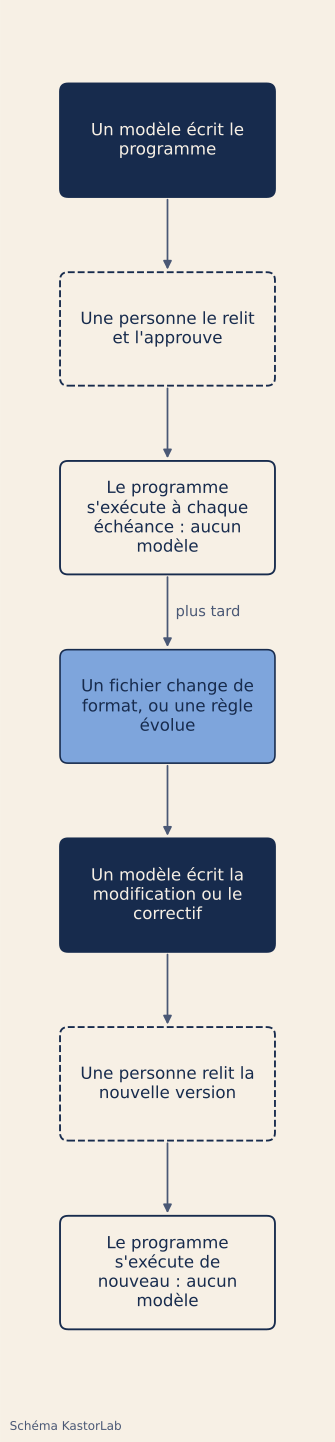
Sur ce parcours, un modèle est appelé à deux moments, à l’écriture puis à la modification, et pas à l’exécution. Dans la vie réelle, la boucle se répète à chaque changement : le schéma la déroule sans la répéter. Le tableau reprend chaque moment, dont deux que le schéma ne montre pas : l’adaptation à un autre fichier et la conversation.
| Moment | Un modèle est-il appelé ? | Ce qui le déclenche |
|---|---|---|
| Écrire le programme | Oui, si un modèle l’écrit | La demande de création |
| L’exécuter | Non, sauf appel dans son code [1] | Un planning, un lancement manuel |
| Le modifier | Oui, si un modèle écrit la modification | Une règle qui change, un résultat à corriger |
| Le réparer | Oui, si un modèle écrit le correctif | Le fichier habituel change de structure |
| L’adapter | Oui, si un modèle écrit l’adaptation | Un autre fichier que celui de l’exemple |
| Discuter avec un assistant | Oui, avec l’historique [4], sauf si la demande lance un agent existant | Un message envoyé |
Un développeur peut écrire la modification à la place d’un modèle : l’appel disparaît, le temps d’une personne le remplace. Les lignes sans numéro de source sont le raisonnement de cet article. La dernière ligne n’est pas une exécution de programme. L’API Messages d’Anthropic est sans état, donc l’historique complet de la conversation est renvoyé à chaque requête [4]. Au 4 novembre 2026, une bêta, les « message threads », permet de n’envoyer que les nouveaux messages [4].
Ce que cela change quand on lit une facture
Le zéro de l’exécution est exact pour un programme qui ne contient pas d’appel de modèle : une exécution sans modèle ne consomme aucun token. Les lignes de facture viennent des autres moments. Les pages de tarifs d’Anthropic et d’OpenAI publient un prix par million de tokens, distinct pour l’entrée et pour la sortie [3] : un appel qui écrit un programme, une modification ou un correctif se facture comme un appel à un modèle d’API. Le coût par tâche, celui qu’il faut suivre, est la somme de ces moments, pas le coût d’une exécution.
Deux conséquences. D’abord, le fournisseur facture l’appel, pas la décision qui suit : une modification relue puis refusée a déjà consommé ses tokens. Ensuite, un prix par token ne dit pas à quel moment de la vie de la tâche un appel appartient. C’est au produit qui appelle le modèle de rattacher chaque appel à un moment, et la dernière question de la liste ci-dessous porte sur ce point.
À vérifier chez votre fournisseur
Cinq questions à poser à un fournisseur de programmes ou d’agents écrits par une IA.
- L’exécution appelle-t-elle un modèle, même dans une de ses étapes ? Une bonne réponse distingue les étapes : un programme qui fait classer un texte par un modèle appelle ce modèle à chaque exécution, et son coût n’est plus celui d’un script.
- Quels autres moments appellent un modèle : modification, réparation, adaptation, conversation ? Une bonne réponse donne la liste, avec pour chaque moment le modèle appelé et l’endroit où il tourne.
- Qui approuve une modification, et que coûte une modification refusée ? Une bonne réponse nomme une personne autre que l’auteur, et dit si le coût de l’appel déjà fait est visible.
- Que fait le programme quand le format d’un fichier change ? Une bonne réponse décrit un arrêt explicite, une explication de la différence, et un correctif proposé à relire plutôt qu’appliqué de lui-même.
- Comment voyez-vous le coût de chaque moment ? Une bonne réponse sépare la création, les modifications et la conversation, et dit si les montants sont mesurés ou estimés.
Comment Nestor y répond
Nestor sépare l’écriture de l’exécution : l’IA écrit l’agent ; l’exécution se fait sans modèle. Une exécution d’agent programme, écrit par Nestor ou connecté à un modèle métier, n’appelle aucun modèle : 0 token. Les agents conversationnels (« instructions ») appellent un modèle à chaque tour ; la conversation en appelle un aussi, sauf quand la demande revient à lancer un agent existant.
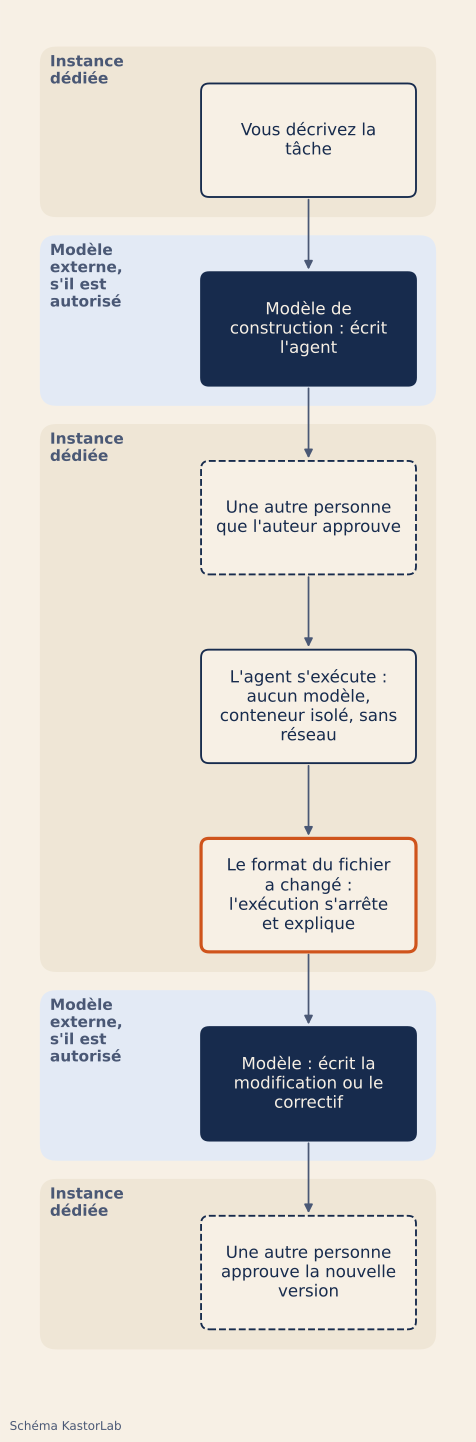
Écrire, modifier, réparer et adapter un agent rappellent en revanche un modèle. L’IA intervient pour écrire l’agent, puis pour chaque modification qu’elle écrit, avant toute approbation : une modification refusée a déjà coûté des tokens. Ce coût de construction est enregistré et visible, en estimation, dans l’écran Coûts.
Quand la structure d’un fichier change, l’exécution s’arrête et explique ce qui diffère. Pour les agents d’une seule étape écrits par Nestor, une réparation peut être proposée : un correctif relu, construit à partir de la seule différence de structure, à approuver. Les modèles métier inclus tournent sans modèle d’IA et s’utilisent tels quels sur des fichiers de même structure que l’exemple ; sinon ils sont adaptés, et l’IA écrit un adaptateur, relu par un collègue.
L’auteur d’un agent ou d’une modification ne peut pas l’approuver. Chaque agent garde un historique de versions, et le dossier d’audit, scellé pour l’intégrité, exporte par agent et par période les versions, les approbations et les empreintes des fichiers lus.
Dans la conversation, un modèle répond, sauf quand la demande revient à lancer un agent existant, comme « vérifie les factures de ce matin » : Nestor lance alors l’agent plutôt que d’appeler un modèle, pour 0 token, et la réponse le dit.
Pour limiter ce qui coûte, Nestor route, en mode automatique, vers le modèle le moins coûteux capable de la tâche. Un modèle local n’est pas facturé au token, ce qui ne vaut que pour un modèle installé sur l’infrastructure du client. Les corrections sont ciblées : 3 essais au plus, sur les écarts et sans les valeurs.
Le modèle de construction recommandé est Claude (Anthropic) ; en mode « interne uniquement », aucun modèle externe n’est appelé, et la construction se fait avec un modèle local, plus lent, qui peut ne pas suffire pour les tâches complexes. L’instance dédiée est une pile isolée par entreprise : gérée par KastorLab dans l’Union européenne, ou déployée sur l’infrastructure de l’entreprise avec l’offre Souverain.
La valeur récurrente de Nestor tient en une phrase : garder l’automatisation correcte, prouvable et privée dans le temps, pas l’écrire une fois. Pour faire l’exercice avec vos propres hypothèses, le simulateur compare la facture d’une IA frontier avec l’exécution d’un agent Nestor : ses montants sont illustratifs (« Illustration. Chiffres non contractuels »), et il mentionne le coût de construction de l’agent sans le compter.
Limites
Cet article ne contient aucun montant. Nous n’avons mesuré ni les tokens d’une modification, ni ceux d’une réparation, ni ceux d’une conversation sur un agent réel, et Nestor affiche son coût de construction en estimation. Le cache des instructions communes avec Claude est pris en charge ; nous ne l’avons pas mesuré. Le tableau ne compte pas le temps de la personne qui relit chaque modification, ni celui d’un développeur quand ce n’est pas un modèle qui écrit le correctif.
La réparation proposée par Nestor ne concerne que les agents d’une seule étape écrits par Nestor : pour les autres, l’exécution s’arrête et explique, et cet article ne décrit pas la suite. Nous ne décrivons pas non plus comment une demande est rapprochée d’un agent existant dans la conversation, ni ce que contient chaque envoi vers un modèle externe : historique, mémoires d’équipe retrouvées, texte des fichiers joints. Enfin, un programme qui appelle lui-même un modèle dans une de ses étapes suit un autre profil de coût, que la première question de la liste ci-dessus permet de repérer.
Nestor est en version 0.1, en développement actif, avec un accès progressif par liste d’attente : l’article décrit les mécanismes de cette version, pas un résultat mesuré sur la durée.
Sources
- Un agent IA n’est pas une solution par défaut, Olga Dudko, Journal du Net, 16 avril 2026, consulté le 4 novembre 2026.
- Le coût caché des agents IA : pourquoi des modèles moins chers ne signifient pas toujours un modèle IA moins coûteux, Aimane Essaidi, Leyton, 2 septembre 2026, consulté le 4 novembre 2026.
- Pages de tarifs d’Anthropic et d’OpenAI, consultées le 4 novembre 2026 (aucun prix n’est repris dans cet article).
- Using the Messages API, section « Multiple conversational turns », documentation d’Anthropic, consultée le 4 novembre 2026.