Sécurité · Mécanisme
Fournisseur d'IA : cinq questions sur ce que le modèle reçoit
Cinq questions à poser à un fournisseur d'IA avant de lui confier des fichiers : contenu de chaque envoi, fichiers joints, journal, conservation, et un test à faire.
Par Yaniv Benichou Publié le 9 min de lecture
En bref
Avant de confier des fichiers à un fournisseur d’IA, demandez-lui ce que son modèle reçoit réellement : une requête composée par l’application, pas votre seul message. Cinq questions le vérifient : le contenu de cette requête, le sort des fichiers joints, ce que le journal garde, ce que le fournisseur du modèle conserve ou réutilise, et un test avec un mot repère. Chacune est suivie de ce qu’une bonne réponse contient.
Que demander à un fournisseur d’IA avant de lui confier des fichiers ?
Vous choisissez un assistant d’IA pour votre entreprise et vous cherchez la liste de questions à poser. Vous tombez sur celle de Glean, un éditeur d’assistants d’entreprise : « 9 key questions for evaluating AI assistant vendors in 2026 », mise à jour le 26 avril 2026 [1]. Son titre annonce neuf questions ; son texte en numérote sept. Elle demande une carte de chaque étape du trajet d’une requête, de l’assemblage du prompt à l’inférence, un engagement écrit de non-entraînement qui couvre les prompts, les fichiers, les sorties et les métadonnées, les durées de conservation de l’historique de conversation, du contexte en cache et des journaux, et l’export des journaux vers vos outils de sécurité [1].
Ce qu’elle rate : elle parle de fichiers dans l’engagement de non-entraînement, mais le texte de la page ne contient ni le mot « image », ni « attach », ni « upload ». Il ne dit pas ce que devient un fichier joint à une conversation, ni à quoi ressemble la requête, ni comment la relire. Le guide de l’ANSSI sur la sécurité des systèmes d’IA générative, publié le 29 avril 2024, va plus près : il demande de distinguer ce que l’utilisateur tape de « les données réellement envoyées au modèle d’IA », et de journaliser les deux [2]. Mais il s’adresse à celui qui exploite le système ; pour les outils d’IA générative sur Internet, sa recommandation R34 est de les proscrire dès que des données sensibles sont en jeu [2].
Nos deux articles précédents ont traité ce qui part pendant la construction d’un agent, puis pendant une conversation. Celui-ci en tire cinq questions que vous pouvez poser.
KastorLab vend un service d’IA en entreprise : pour ce sujet, nous sommes un concurrent des fournisseurs à qui ces questions s’adressent, comme Glean. Cet article décrit un mécanisme technique ; il ne constitue pas un conseil juridique.
Le modèle reçoit une requête composée, pas votre message
Un modèle ne garde pas la conversation. Chez Anthropic, l’API Messages est sans état : l’application envoie l’historique complet à chaque requête [4]. Chez OpenAI, chaque requête de génération de texte est indépendante et sans état [5]. Entre ce que vous tapez et ce que le modèle lit, il y a donc une étape, celle de l’application. L’ANSSI note que les requêtes des utilisateurs peuvent faire l’objet d’un pré-traitement et d’une mise en forme avant l’envoi au modèle [2]. Cette étape décide quoi ajouter : l’historique, des passages retrouvés dans des mémoires, le texte des fichiers joints.
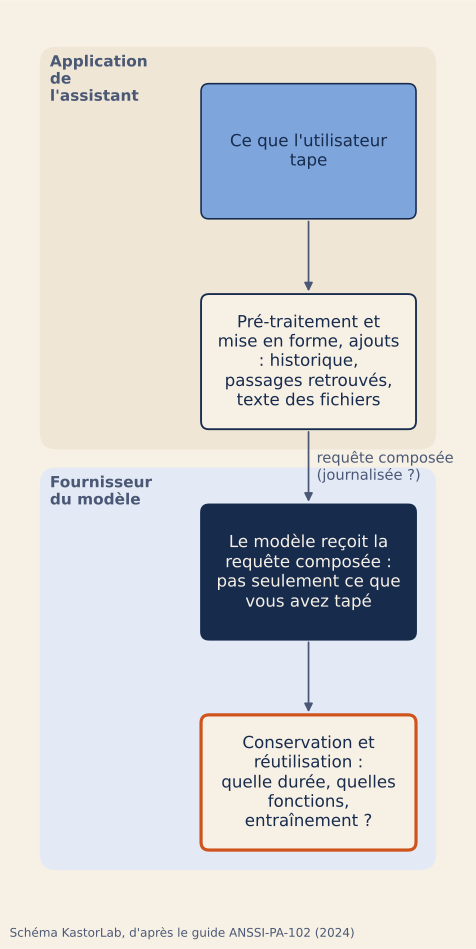
Cela déplace deux questions. Le journal de l’application peut contenir la saisie seule ou la requête composée : l’ANSSI veut les deux traçables, pour pouvoir reconstituer entièrement un événement [2]. Et ce qui part chez le fournisseur du modèle dépend de sa conservation et de ses règles de réutilisation : pour un système utilisé par API, la CNIL écrit que « la maîtrise du système est alors quasi exclusivement dans les mains du fournisseur » [3].
À vérifier chez votre fournisseur
Ces cinq questions s’adressent à l’éditeur de l’assistant, qui doit répondre aussi pour le fournisseur du modèle qu’il appelle. Elles tiennent sans Nestor et complètent les trois de l’article précédent sur la conversation.
- Que contient la requête que le modèle reçoit, par rapport à ce que l’utilisateur a tapé ? Une bonne réponse liste les ajouts (historique, passages retrouvés, texte des fichiers, images), dit à quel moment l’application les fait, et sait montrer la requête composée pour un message donné.
- Que devient un fichier joint : quel texte, quelles images, pour combien de messages ? Une bonne réponse dit si le texte extrait part seul ou avec des images de pages, si le fichier repart avec chaque message suivant parce qu’il est dans l’historique ou s’il est retrouvé à la demande, et ce que le masquage éventuel couvre, texte comme images.
- Qu’est-ce qui est journalisé, pour combien de temps, et qui peut le lire ? Une bonne réponse distingue la saisie et la requête composée, nomme les traitements faits avant l’envoi et les appels à des données additionnelles, fixe une durée de conservation, et protège le journal comme les données qu’il contient [2].
- Que fait le fournisseur du modèle de ce qu’il reçoit ? Une bonne réponse donne une durée par type de contenu (conversation, fichier, journal, sauvegarde), un engagement écrit de non-entraînement qui couvre les prompts, les fichiers, les sorties et les métadonnées et vaut pour chaque fournisseur en aval [1], un réglage qui désactive la réutilisation des données d’usage [3], et ce qui échappe à ces engagements.
- Pouvez-vous retrouver dans votre journal un mot repère que je choisis ? C’est un test que nous proposons : inventez un mot, écrivez-le dans un message, mettez-en un autre dans un fichier joint, envoyez, puis demandez qu’on retrouve les deux dans la trace de ce qui est parti. Une bonne réponse les retrouve rapidement, dit ce qui a été masqué avant l’envoi et pour combien de temps la trace reste. Si seul le mot tapé apparaît, ou s’il n’y a pas de trace du tout, vous ne pouvez pas vérifier par ce moyen ce qui part.
Comment Nestor y répond
Nestor est le produit phare de KastorLab : nous avons un intérêt direct à ce sujet.
Si un modèle externe est autorisé : en conversation, chaque message part avec l’historique, les mémoires d’équipe retrouvées et le texte des fichiers joints ; pour lire une image ou un scan sans modèle local capable, l’image elle-même. Le texte (pas les images) passe par un masquage automatique de certaines données personnelles (e-mails, IBAN, numéros…). Les envois sont journalisés et signalés dans la conversation. Ce masquage n’est pas une anonymisation.
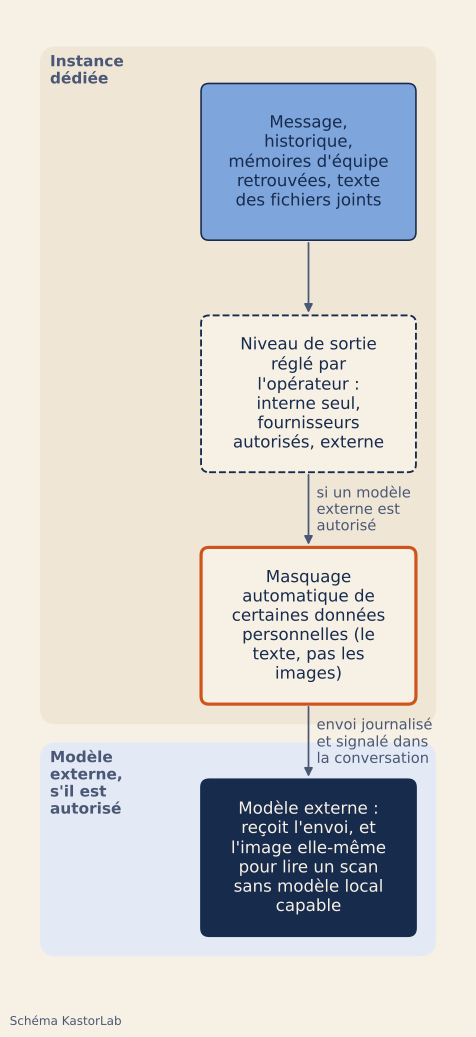
Trois niveaux de sortie (interne seul, fournisseurs autorisés, externe) sont réglés par l’opérateur, jamais par un écran utilisateur. Dans le mode zéro fuite, les fournisseurs externes ne sont même pas instanciés : seuls les modèles de l’infrastructure du client répondent. Le masquage des données personnelles a lieu avant tout envoi, avec une ligne d’audit par franchissement. En mode « interne uniquement » : aucun modèle externe, aucune recherche web.
Pour la construction d’un agent, le modèle reçoit la demande, les noms et la structure des fichiers (colonnes, formats, lignes inventées), jamais les lignes réelles. Vous voyez ce qui a été envoyé. Le détail de ce qui part tout de même, libellés de catégories compris, est dans l’article sur la structure.
Nestor tourne dans une instance dédiée à l’entreprise : une pile isolée, gérée par KastorLab dans l’Union européenne (offres Team et Business), ou déployée sur l’infrastructure du client (offre Souverain). Si l’entreprise autorise un modèle externe, ce n’est plus une boucle fermée.
Face à vos cinq questions, ces lignes répondent aux questions 1 et 2. Pour la question 3, elles disent que les envois sont journalisés, pas ce que le journal contient ni combien de temps il est gardé. Elles ne disent rien de ce que conserve le fournisseur du modèle (question 4), et nous n’avons pas fait le test de la question 5 sur Nestor. Si vous voulez faire cet exercice sur vos propres outils et fichiers, c’est le point de départ d’un audit avec nous.
Limites
Nous n’avons testé aucun produit : le test du mot repère n’a été essayé chez aucun fournisseur. Les faits viennent de pages lues le 5 novembre 2026, dont la page de Glean, mise à jour le 26 avril 2026, le guide de l’ANSSI d’avril 2024 et les questions-réponses de la CNIL de juillet 2024 ; elles évoluent, et d’autres fournisseurs peuvent faire autrement. Le test montre ce que le journal de l’application garde : l’absence d’un mot dans ce journal ne prouve pas qu’il n’est pas parti, et il ne dit rien de ce que le fournisseur du modèle conserve.
L’article ne couvre ni les clauses contractuelles et la sous-traitance, ni les certifications, ni le lieu où les données sont traitées, ni les comptes connectés (quand une messagerie ou LinkedIn est connecté, Nestor échange avec ce service), ni la dictée vocale. Ce sont les suites possibles.
Pour Nestor, il ne dit pas quel est le contenu du journal des envois, qui peut le lire ni combien de temps il est conservé ; comment le masquage reconnaît une donnée au-delà des exemples cités ; ce que devient le texte d’un fichier joint aux messages suivants ; ni ce que conserve le fournisseur du modèle. Pour la construction, le mode « interne uniquement » avec un modèle local est plus lent et peut ne pas suffire pour les tâches complexes. Notre page Sécurité traite aussi de ces envois.
Sources
- 9 key questions for evaluating AI assistant vendors in 2026, The Glean Team, Glean, mise à jour le 26 avril 2026, consultée le 5 novembre 2026.
- Recommandations de sécurité pour un système d’IA générative, ANSSI-PA-102, version 1.0 du 29 avril 2024, recommandations R29 et R34, consulté le 5 novembre 2026.
- Les questions-réponses de la CNIL sur l’utilisation d’un système d’IA générative, CNIL, 18 juillet 2024, sections 5 et 6, consultées le 5 novembre 2026.
- Using the Messages API, section « Multiple conversational turns », documentation Anthropic, consultée le 5 novembre 2026.
- Conversation state, documentation OpenAI, consultée le 5 novembre 2026.