Sécurité · Mécanisme
Ce qui part vers le modèle quand vous discutez avec votre assistant
À chaque message, l'application renvoie au modèle l'historique et d'autres textes. Ce que le fournisseur reçoit, ce qu'il conserve, et trois questions à poser.
Par Yaniv Benichou Publié le 11 min de lecture
En bref
Un modèle ne garde pas la conversation d’un message à l’autre : c’est l’application qui lui renvoie, à chaque message, tout ce qu’il doit connaître. Dans un assistant d’entreprise, cela comprend l’historique, les passages retrouvés dans les mémoires, le texte des fichiers joints et, parfois, l’image elle-même. Ce que contient cet envoi, ce que le fournisseur en conserve et ce que l’entreprise en voit se vérifient : trois questions suffisent pour commencer.
Que reçoit le fournisseur quand vous discutez avec votre assistant ?
Vous posez une question à l’assistant de votre entreprise, il répond, et vous voulez savoir ce que le fournisseur du modèle a reçu pour cela. Deux articles récents traitent d’une question voisine : pourquoi une IA oublie ce que vous lui avez dit.
La lecture courante : le modèle n’a pas de mémoire propre, il relit toute la conversation à chaque message. L’article « Why does AI forget what you said (and how to fix it) » de Rohini Gaonkar, publié sur AWS Builder Center le 25 mai 2026, le dit ainsi [1]. L’article de Graham Morley sur DEV Community, publié le 20 avril 2026, ajoute que des passages retrouvés dans une base sont insérés dans le prompt avec votre message [2]. Ce qu’elle rate : ni l’un ni l’autre ne traite de confidentialité ni de journalisation, alors que dans un assistant d’entreprise, chaque message porte plus que la question : l’historique, les mémoires d’équipe retrouvées, le texte des fichiers joints, parfois l’image elle-même. Et ce qui part peut être journalisé et signalé côté entreprise.
Notre article précédent, Ce que reçoit le modèle quand il construit un agent sur vos fichiers, traitait de la construction d’un agent. Celui-ci traite de la conversation.
Le modèle ne garde pas la conversation : l’application la renvoie à chaque message
Les deux fournisseurs dont nous avons lu la documentation le disent. Chez Anthropic, l’API Messages est sans état : l’application envoie l’historique complet à chaque requête [3]. Chez OpenAI, chaque requête de génération de texte est indépendante et sans état ; pour tenir une conversation, on ajoute les messages précédents en paramètres [4].
Chaque message est donc une requête complète : votre question, l’historique et ce que l’application va chercher ailleurs. La réponse du modèle s’ajoute à l’historique et repartira avec le message suivant. Une application peut aussi résumer ou supprimer les plus anciens messages quand la conversation dépasse la fenêtre de contexte [2].
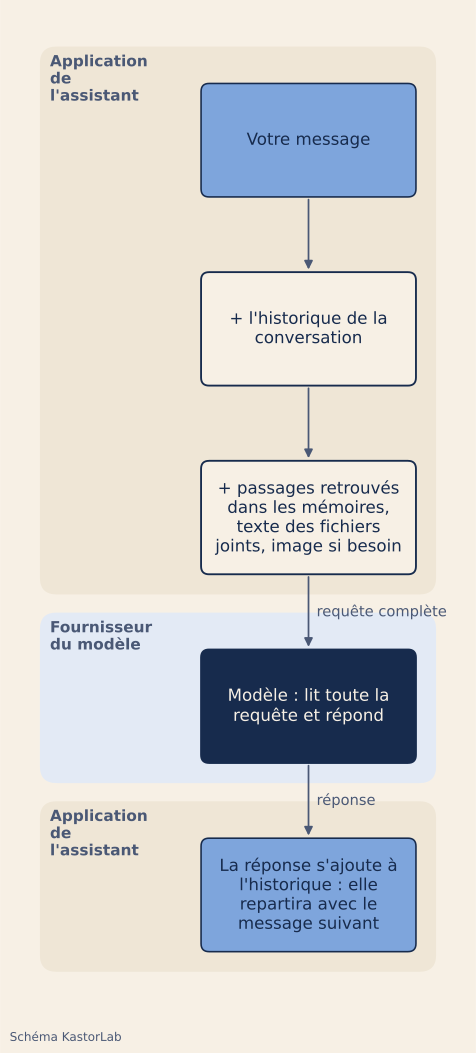
Trois cas déplacent la question plutôt qu’ils ne la suppriment. Chez Anthropic, au 4 novembre 2026, les fils de messages (en bêta) gardent la conversation sur le serveur : l’application n’envoie plus que les nouveaux messages, et le fil est supprimé au plus tard 1 heure après sa dernière utilisation [3][5]. Chez OpenAI, previous_response_id chaîne les réponses, et tous les tokens d’entrée précédents de la chaîne sont facturés comme tokens d’entrée [4] ; l’API Conversations, elle, conserve l’état d’une conversation comme un objet de longue durée, doté d’un identifiant durable [4]. Dans ces trois cas, c’est le fournisseur qui détient l’historique.
Ce qu’un message de conversation transporte
Ce qui s’ajoute à votre question dépend de l’application, pas du modèle : l’API accepte du texte et des images, et l’application décide quoi y mettre.
| Ce qui s’ajoute à votre question | Ce que reçoit le fournisseur | Condition et source |
|---|---|---|
| L’historique | Tous les échanges précédents | À chaque message, sauf résumé ou fil gardé par le fournisseur [2][3][4] |
| Des passages retrouvés | Le texte retrouvé dans une mémoire ou une base | L’application l’ajoute à la requête [2][6] |
| Le texte d’un fichier joint | Le texte extrait du fichier | OpenAI : texte seul pour un .docx ou un .txt [7] |
| L’image d’une page | L’image elle-même, avec le texte | PDF, sur les modèles qui lisent les images [7][8] |
Pour un PDF, Anthropic fournit à Claude le texte extrait et l’image de chaque page [8] ; OpenAI fait de même sur les modèles qui lisent les images [7]. Deux assistants qui appellent le même modèle peuvent donc envoyer des choses très différentes : ce qui part se lit dans l’application, pas dans le nom du modèle.
Ce que le fournisseur conserve, et ce que l’entreprise en voit
Ce que le fournisseur fait de ces requêtes dépend de lui, de la fonction utilisée et du contrat, et sa documentation peut se contredire elle-même. Au 4 novembre 2026, OpenAI génère des journaux de détection d’abus pour tout usage de l’API et les conserve jusqu’à 30 jours, sauf obligation légale ou nécessité de protéger ses services ; l’API Responses prévoit aussi, par défaut, 30 jours de rétention de l’état d’application, et l’API Conversations indique « Until deleted » (jusqu’à suppression) pour les journaux d’abus comme pour l’état d’application [9]. Chez Anthropic, deux pages ne se recoupent pas à cette date : le Privacy Center indique que les entrées et les sorties de l’API sont supprimées de ses systèmes dans les 30 jours suivant leur réception ou leur génération, sauf exceptions [10] ; la page de documentation « API and data retention » écrit que le contenu des conversations n’est pas conservé par défaut, sauf pour les modèles dits couverts, qui exigent 30 jours de rétention [11]. C’est une raison de poser la question 2 ci-dessous et d’en demander la réponse par écrit.
Les deux proposent la rétention zéro à certains clients, avec des limites. Chez OpenAI, le contenu est alors exclu des journaux d’abus, mais les fonctions marquées non éligibles, dont l’API Conversations, peuvent conserver un état d’application même sous rétention zéro [9]. Chez Anthropic, les prompts et les réponses ne sont pas stockés au repos (« at rest ») une fois la réponse de l’API renvoyée [11] ; la même page précise que, même sous rétention zéro, Anthropic peut conserver des données lorsque la loi l’exige ou lorsque ses systèmes de sécurité automatisés les signalent, jusqu’à 2 ans pour un échange signalé, et que les modèles couverts n’y sont disponibles que sur autorisation expresse [11]. Les fils de messages en bêta d’Anthropic n’y sont pas éligibles [5].
Côté entreprise, un journal qui consigne le contenu de chaque envoi permet de relire ce qui est parti ; sans un tel journal, reconstituer ce qu’un message a envoyé relève de la supposition. Ce qui peut partir se règle lui aussi là où l’application le permet, par un administrateur ou par chaque utilisateur, et un masquage éventuel ne vaut que pour ce qu’il couvre. Ces propriétés sont celles de l’application, pas du modèle.
À vérifier chez votre fournisseur
Ces trois questions s’adressent à l’éditeur de l’assistant, qui doit pouvoir répondre aussi pour le fournisseur du modèle qu’il appelle. Elles tiennent sans Nestor.
- Que contient exactement chaque envoi vers le modèle, et peut-on le relire ? Une bonne réponse nomme l’historique, les passages retrouvés, le texte des fichiers et les images, dit si le masquage éventuel couvre le texte comme les images, et donne un moyen de relire ce qui est parti pour un message donné.
- Que conserve le fournisseur du modèle, pour quelle durée et pour quelles fonctions ? Une bonne réponse donne une durée par fonction (journaux, conversations gardées côté serveur, fichiers), nomme le régime de rétention zéro quand il existe et liste les fonctions qui en sont exclues.
- Qui peut autoriser l’envoi vers un modèle externe, et peut-on l’interdire entièrement ? Une bonne réponse décrit un réglage d’administrateur, non un interrupteur que chaque utilisateur peut changer, et un mode où aucun modèle externe n’est appelé.
Comment Nestor y répond
Nestor est le produit phare de KastorLab : nous avons donc un intérêt direct à ce sujet.
Si l’entreprise autorise un modèle externe (Claude d’Anthropic, GPT d’OpenAI ou Gemini de Google), chaque message de la conversation part avec l’historique, les mémoires d’équipe retrouvées et le texte des fichiers joints, sauf quand la demande revient à lancer un agent existant : le chat lance alors cet agent plutôt que d’appeler un modèle (0 token, et la réponse le dit). Pour lire une image ou un scan sans modèle local capable, l’image elle-même part. Le texte, pas les images, passe par un masquage automatique de certaines données personnelles (e-mails, IBAN, numéros…) ; ce masquage n’est pas une anonymisation. Les envois sont journalisés et signalés dans la conversation.
Les mémoires d’équipe sont retrouvées par mots et, si le serveur a un modèle d’embedding, par sens.
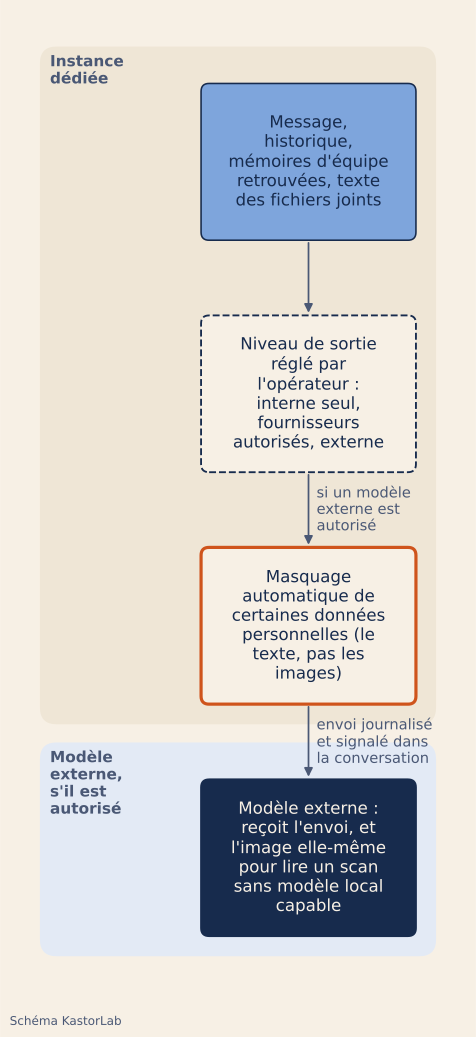
Nestor a trois niveaux de sortie (interne seul, fournisseurs autorisés, externe), réglés par l’opérateur, jamais par un écran utilisateur. En mode « interne uniquement » : aucun modèle externe, aucune recherche web. Dans le mode que Nestor nomme « zéro fuite », les fournisseurs externes ne sont même pas instanciés : seuls les modèles de l’infrastructure du client répondent. Le texte est masqué avant l’envoi (pas les images), avec une ligne d’audit par franchissement. La recherche web est facultative : seuls les mots de la recherche sortent.
Nestor tourne dans une instance dédiée à l’entreprise : une pile isolée, gérée par KastorLab dans l’Union européenne (offres Team et Business), ou déployée sur l’infrastructure du client (offre Souverain). « En boucle fermée » désigne l’exécution des agents dans un conteneur isolé, sans réseau, et le mode « interne uniquement » ; si l’entreprise autorise un modèle externe, ce n’est plus une boucle fermée. Notre audit comprend l’inventaire de vos usages d’IA : outils, modèles, données concernées.
Limites
Nous n’avons rien mesuré : aucun appel à l’API d’un fournisseur, aucune capture du trafic d’un assistant. Les faits sur les fournisseurs viennent de la documentation d’Anthropic et d’OpenAI du 4 novembre 2026 ; elle change, et d’autres fournisseurs peuvent faire autrement.
Cet article ne dit pas, pour Nestor, quel est le contenu du journal des envois, qui peut le lire ni combien de temps il est conservé ; comment le masquage reconnaît une donnée au-delà des exemples cités ; combien de mémoires remontent pour un message ; ni ce que devient le texte d’un fichier joint aux messages suivants. Il ne couvre pas non plus les comptes connectés (quand une messagerie ou LinkedIn est connecté, Nestor échange avec ce service) ni la dictée vocale.
La construction d’un agent suit un autre chemin, décrit dans l’article précédent : le modèle y reçoit la structure des fichiers, pas leurs lignes. Pour la construction, le mode « interne uniquement » avec un modèle local est plus lent et peut ne pas suffire pour les tâches complexes ; nous n’avons pas mesuré la qualité d’un modèle local en conversation. Notre page Sécurité traite aussi de ces envois.
Sources
- Why does AI forget what you said (and how to fix it), Rohini Gaonkar, AWS Builder Center, publié le 25 mai 2026, modifié le 2 juillet 2026, consulté le 4 novembre 2026.
- How AI Memory Actually Works : Context Windows and RAG, Graham Morley, DEV Community, publié le 20 avril 2026, consulté le 4 novembre 2026.
- Using the Messages API, section « Multiple conversational turns », documentation Anthropic, consultée le 4 novembre 2026.
- Conversation state, documentation OpenAI, consultée le 4 novembre 2026.
- Message threads, documentation Anthropic (bêta), consultée le 4 novembre 2026.
- Memory tool, documentation Anthropic, consultée le 4 novembre 2026.
- File inputs, documentation OpenAI, consultée le 4 novembre 2026.
- PDF support, documentation Anthropic, consultée le 4 novembre 2026.
- Data controls in the OpenAI platform, documentation OpenAI, consultée le 4 novembre 2026.
- How long do you store my organization’s data?, Anthropic Privacy Center, section « Standard Retention Timeframe », consulté le 4 novembre 2026.
- API and data retention, section « Zero data retention (ZDR) », documentation Anthropic, consultée le 4 novembre 2026.