Sécurité · Mécanisme
Ce que reçoit le modèle quand il construit un agent sur vos fichiers
Pour écrire un agent sur vos fichiers, un modèle a besoin de leur structure, pas de leurs lignes. Ce qui part vraiment, ce qui fuit encore, et la réponse de Nestor.
Par Yaniv Benichou Publié le 8 min de lecture
En bref
Pour écrire un programme qui traite un fichier, un modèle a besoin de sa structure : les noms de colonnes, les types, les formats et quelques lignes inventées. Les lignes réelles n’ont pas à partir, puisque c’est le programme qui les lira. Trois choses partent quand même : les noms, les libellés des catégories et la demande elle-même.
« Pas de données confidentielles dans les prompts » : ce que la règle interdit vraiment
La règle est fondée. Un export de paie collé dans un assistant en ligne part chez le fournisseur du modèle, avec les noms, les IBAN et les salaires. Prise à la lettre, elle semble pourtant exclure tout usage d’un modèle sur les fichiers de l’entreprise.
Elle vise d’abord les lignes, et pour écrire un programme, les lignes n’ont pas besoin de partir. Ce qui part encore, les noms, les libellés et la demande, peut lui aussi être confidentiel : nous y revenons plus bas. Pour les données personnelles, le RGPD formule un principe voisin, la minimisation, à l’article 5, paragraphe 1, point c) [1] : les données doivent être « adéquates, pertinentes et limitées à ce qui est nécessaire au regard des finalités pour lesquelles elles sont traitées ». Cet article décrit un mécanisme technique ; il ne constitue pas un conseil juridique.
Pour écrire ce programme, la structure du fichier suffit
Prenons une demande de service RH : chaque mois, lister les salariés embauchés il y a plus de cinq ans dont le salaire brut est sous la médiane de leur service. Pour écrire ce programme, il faut savoir qu’il existe une colonne de date d’embauche au format année-mois-jour, une colonne de salaire décimale et une colonne de service qui prend cinq valeurs. Il ne faut connaître ni le salaire de quiconque, ni le nom d’un seul salarié.
Le travail se coupe donc en deux temps. À la construction, le modèle reçoit la demande et la structure du fichier, puis écrit le programme. À l’exécution, le programme lit les lignes réelles, sans le modèle.
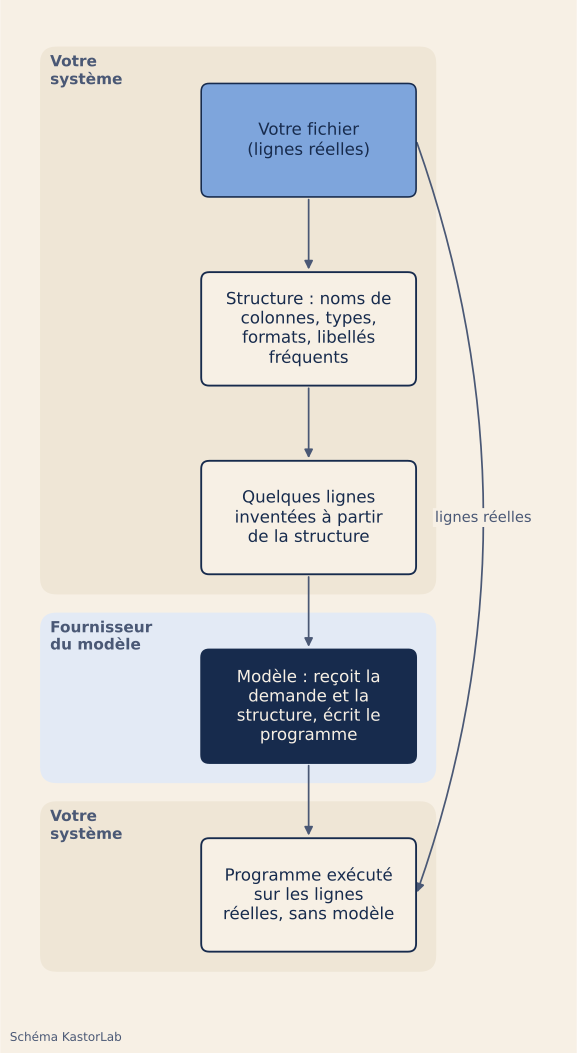
La structure garde la forme de chaque colonne, pas son contenu : une date devient 9999-99-99, un identifiant AAA-99999, et seule la part de cellules vides est notée. Une exception : les libellés d’une colonne de catégories, comme le nom du service, restent tels quels. Les lignes inventées montrent au modèle à quoi ressemble une ligne complète, par exemple le point comme séparateur décimal. Elles sont tirées de la structure seule, jamais du fichier.
Sur un export de paie fictif, ce qui part et ce qui reste
Pour le vérifier, nous avons écrit un script de démonstration, qui n’est pas le code de Nestor, et nous l’avons lancé sur un export de paie inventé : 200 lignes, 9 colonnes, des noms, des e-mails et des IBAN fictifs. Le script tire la structure du fichier, fabrique trois lignes inventées, puis cherche dans ce qui partirait chaque valeur réelle du fichier.
La charge complète, demande comprise, pèse 2 104 octets, contre 22 117 pour le fichier (mesure KastorLab du 3 novembre 2026). Elle contient des valeurs réelles d’un seul genre : les libellés des colonnes de catégories, ici les cinq services, et les valeurs yes et no de la colonne long_term_illness (maladie de longue durée). Chacun de ces libellés est partagé par au moins dix lignes. En dehors d’eux, le contrôle ne trouve dans la charge aucune autre valeur du fichier.
Nous avons ensuite simulé deux erreurs humaines. Une vraie ligne collée « pour l’exemple » est repérée sur 7 de ses 9 valeurs. Les deux qui passent sont le service, parce que c’est un libellé autorisé, et la valeur no de la colonne long_term_illness, libellé autorisé lui aussi et trop court pour être cherché : le contrôle ignore les valeurs de moins de quatre caractères. Une demande, écrite en anglais pour le test, qui demande d’exclure Camille Martin est repérée sur deux valeurs du fichier : le prénom Camille et le nom Martin. Aucune ligne ne porte ces deux valeurs ensemble : le contrôle les trouve chacune sur d’autres lignes.
Un tel contrôle rattrape les erreurs grossières, pas toutes. Un prénom de trois lettres présent dans le fichier, comme Léa, lui échapperait. À l’inverse, comme il cherche chaque valeur comme fragment de texte, il signalerait Martine, absente du fichier, parce que le fichier contient Martin. Il ne dispense pas de relire ce qui part.
Ce qui part quand même : les noms, les libellés, la demande
Les noms de colonnes partent, et ils parlent. Une colonne long_term_illness apprend au fournisseur du modèle que l’entreprise suit des maladies de longue durée, sans qu’une seule ligne parte. Ce nom ne dit rien de la santé d’une personne, mais il révèle que l’entreprise traite des données concernant la santé, l’une des catégories particulières de l’article 9, paragraphe 1, du RGPD [1]. Le nom du fichier part aussi, et « plan_social_2027.csv » en dit plus long que ses colonnes.
Les libellés partent. Cinq noms de services, c’est anodin. Une colonne de catégories qui contient des noms de clients, de projets ou de sites l’est beaucoup moins : un seuil de fréquence écarte les valeurs rares, pas les valeurs sensibles.
La demande part en entier. Demander d’exclure Camille Martin envoie ce nom, quoi que fasse la structure du fichier.
L’idée reçue à corriger est donc la suivante : envoyer la structure ne veut pas dire que rien ne part. Cela veut dire que ce qui part tient en quelques lignes lisibles, qu’une personne peut relire avant l’envoi.
Comment Nestor y répond
Nestor construit ses agents à partir de la structure des fichiers. Le modèle reçoit la demande, les noms et la structure des fichiers (colonnes, formats, lignes inventées), jamais les lignes réelles. Avant l’envoi, la structure passe un contrôle de fuite, et vous voyez ce qui a été envoyé.
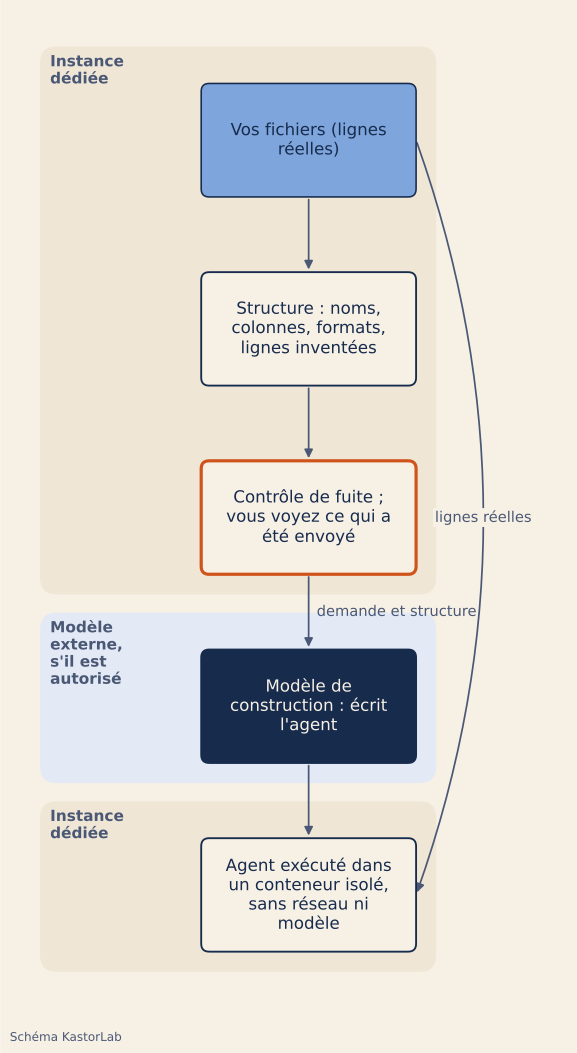
L’IA écrit l’agent ; l’exécution se fait sans modèle. L’agent tourne dans un conteneur isolé, sans réseau, dans l’instance dédiée de l’entreprise : une pile isolée, gérée par KastorLab dans l’Union européenne, ou déployée sur l’infrastructure de l’entreprise avec l’offre Souverain. Les modifications, les réparations et les adaptateurs, eux, rappellent un modèle.
Le programme est testé : il tourne sur le serveur, et son résultat est comparé cellule par cellule à celui de l’équipe, avec jusqu’à 3 essais. Les corrections sont ciblées : le modèle reçoit les écarts, sans les valeurs. Si la structure d’un fichier change plus tard, l’exécution s’arrête et explique ce qui diffère ; pour les agents d’une seule étape écrits par Nestor, un correctif construit à partir de la seule différence de structure peut être proposé, à approuver.
Pour la construction, nous recommandons Claude (Anthropic). Le mode « interne uniquement » n’appelle aucun modèle externe et ne fait aucune recherche web : la construction se fait alors avec un modèle local, plus lent, qui peut ne pas suffire pour les tâches complexes.
Les noms de colonnes et la demande partent tout de même vers le modèle de construction, comme dans la démonstration ci-dessus. Si vous voulez faire cet exercice sur vos propres outils et fichiers, c’est le point de départ d’un audit avec nous.
Limites
Nous n’avons appelé aucun modèle : la démonstration montre ce qui partirait, pas la qualité du programme qu’un modèle écrirait à partir de cette seule structure. Elle ne garde que le format le plus fréquent de chaque colonne, et des lignes inventées au hasard ne transmettent aucune règle implicite, comme des codes internes dont le sens n’est écrit nulle part.
Le test porte sur un seul fichier CSV fictif, sur un MacBook, avec Python 3.12.7 et sa bibliothèque standard. Le contrôle compare des chaînes exactes, sans tenir compte de la casse : il ne voit ni une valeur reformatée (3 685,69 au lieu de 3685.69), ni une paraphrase.
Le mécanisme ne couvre que la construction d’un agent. Dans une conversation avec Nestor, si un modèle externe est autorisé, chaque message part avec l’historique, les mémoires d’équipe retrouvées et le texte des fichiers joints ; pour lire une image ou un scan sans modèle local capable, l’image elle-même part. Le texte, pas les images, passe par un masquage automatique de certaines données personnelles (e-mails, IBAN, numéros). Ce masquage n’est pas une anonymisation : ce qui reste en clair peut encore désigner une personne. Notre page Sécurité détaille ces envois.
Sources
- Règlement (UE) 2016/679 (RGPD), article 5, paragraphe 1, point c), et article 9, paragraphe 1, EUR-Lex, consulté le 3 novembre 2026.